Attention이란?
텐서(Tensor)
개념
숫자를 하나 이상의 축으로 배열한 다차원 데이터 구조, 쉽게말하면 다차원 벡터라고 이해해도 크게 무리는 없다.
- 스칼라:
3→ 0차원 텐서 - 벡터:
[1, 2, 3]→ 1차원 텐서 - 행렬:
[[1, 2], [3, 4]]→ 2차원 텐서
텐서의 주요 연산
-
텐서는 (weight)를 통과해도 정보는 보존된다.
- 정보를 담고 있는 텐서 ()는 가중치 ()와 곱해질 때 그대로 유지되는 것이 아니라, 가중치가 정한 기준에 따라 정보가 섞이고 요약되어 출력 텐서로 전달된다.
- 예를 들어 (), ()를 내적하면 ()가 된다.
- 결과값 (14)에는 ()의 두 원소가 모두 반영되어 있지만, (14)만으로 원래의 ()을 복원할 수는 없으므로 모든 정보가 완전히 보존된 것은 아니다.
- 즉, ()가 사라지는 것이 아니라 ()가 바라보는 기준에 따라 하나의 값으로 변환된 것이다.
-
Weighted sum은 각 입력 텐서의 정보가 가중치만큼 반영되어 합쳐진 결과이다.
- 라는 결과가 있다면, 의 정보는 크게, 의 정보는 작게 반영된 것이다.
- 다시 , 로 돌아오면, 이를 내적하면, 는 보다 강하게 반영된 결과가 나온다는 의미이다.
-
(약간의 비약) 내적의 결과는 서로가 얼마나 비슷한 정보를 가지고 있냐를 나타낸다.
- 내적값이 큰 양수이면 두 벡터가 비슷한 방향을 가지고, 0에 가까우면 방향상 관련성이 약하며, 큰 음수이면 서로 반대 방향의 특징을 가진다고 볼 수 있다.
Attention
Attention의 메커니즘
현재 필요한 정보(Query)를 기준으로, 여러 후보(Key)와 비교한 뒤 관련도가 높은 정보(Value)를 많이 가져오는 방식이다.
쉽게 예를 들면, 검색을 한다고 생각하자.
- Query: 내가 찾고 싶은 것
- Key: 각 정보가 무엇에 관한 정보인지 나타내는 표지
- Value: 각 정보가 실제로 담고 있는 내용
Query: “동물과 관련된 정보가 필요해”

Key 1: “날씨”       Value 1: “오늘은 맑다”
Key 2: “동물”       Value 2: “고양이는 잠이 많다”
Key 3: “음식”       Value 3: “사과는 달다”
위 예시에서, Query를 각 Key와 비교하면 Key 2가 가장 관련성이 높다. 이 경우 Value 2를 가장 많이 가져오는 것이다.
Attention의 계산 과정
하나의 Query(), 여러 개의 Key()와 Value(, , )가 있다고 해보자.
[1단계] Query와 각 Key의 관련도 계산
- 내적값이 클수록 Query와 해당 Key가 더 비슷한 정보를 가지고 있다는 뜻이다.
[2단계] Softmax로 가중치 변환
- Softmax란, 입력값을 모두 양수로 변환하고 전체 합을 1로 바꾸어주는 함수이다. ()
- 합을 1로 바꾸는 이유는 '각 값을 전체 중 차지하는 비율'로 해석하기 위함이다.
- 예를 들어, 내적 결과가 다음과 같다면
- Softmax를 적용하면 다음과 같이 변환된다.
- 즉, 두 번째 정보가 가장 중요하다고 판단된 것이다.
[3단계] Value를 가중합 (Value 벡터에 통과)
- 결국 위 값이 Attention의 출력이다.
- 즉, Key는 어떤 Value를 가져올지 고르는 기준이고, 실제로 합쳐지는 정보는 Value이다.
이를 수식으로 나타내면 아래와 같다.
Attention 계산 결과의 의미
위 계산 결과를 의미적으로 해석하면 다음과 같다.
나는 은행에서 돈을 찾았다.
위 문장에서 '은행'이라는 단어만 떼어놓고 보면, 먹는 열매 은행인지, 금융기관 은행인지 알 수 없다.
하지만, '돈', '찾았다'와 같은 단어(토큰)의 정보를 많이 가져오면 '은행'은 금융기관 의미로 해석된다. (단어와 토큰은 완벽히 같지는 않지만 편의상)
- 즉, '은행'이라는 Query에 문맥적 의미를 담기 위해
- 이후 모든 토큰인 '나는', '은행', '에서', '돈', '을', '찾았다'의 Key와의 관련도를 계산하고
- '돈', '찾았다'라는 토큰의 Value를 크게 반영한 결과를 만든다.
- 이 결과는 결국 금융기관이라는 문맥이 반영된 은행을 나타낸다.
Attention의 종류
Self Attention
를 모두 같은 입력 시퀀스에서 만드는 어텐션.
위에서 예시가 Self Attention의 예시이다. 위에서는 '은행'이라는 단어만 언급했지만, 문장안에서 각 단어들이 같은 문장의 다른 단어들을 모두 참고하고 있는 것이다. (위 과정에서의 '은행'은 사실 보다는 엄밀히 말하면 정도로 볼 수 있다.
수식으로 나타내면 아래와 같다.
Cross Attention
와 가 서로 다른 입력 시퀀스에서 만드는 어텐션.
수식으로 나타내면 아래와 같다.
가장 쉬운 예시는 번역이다.
I went to the bank.
위 문장을 한국어로 번역한다고 해보자.
인코더는 영어 문장을 벡터로 만들고, 디코더는 이 벡터를 통해 생성할 한국어 벡터를 계산하려고 한다.
이때 디코더가 '은행'이라는 토큰을 생성하려고 한다고 해보자.
이때, 는 디코더가 현재 가지고 있는 벡터이고, 는 인코더가 만든 벡터 라고 할 수 있다.
이를 의미적으로 해석하면 아래와 같다.
Query:
현재 번역 위치에서 원문으로부터 어떤 정보가 필요한가?

Key:
영어 문장의 각 위치가 어떤 정보를 담고 있는가?

Value:
해당 위치에서 실제로 가져올 문맥 정보
이때, 디코더의 Query가 영어 문장의 모든 Key와 관련도를 계산하면 아래와 같다.
I       → 낮은 관련도
went    → 낮은 관련도
to      → 중간 관련도
the     → 낮은 관련도
bank    → 높은 관련도
이러면 'bank'의 Value가 크게 반영되고 디코더는 '은행'이라는 단어를 생성하는데 필요한 정보를 얻게 된다.
- 전체 어휘 집합에 대한 점수 벡터에서 '은행'이라는 위치에 해당하는 값이 가장 높다는 의미
Positional Encoding
필요성
Self-Attention은 기본적으로 토큰들을 순서 없이 한꺼번에 비교한다.
예를 들어 다음 두 문장은 단어는 같지만 순서가 달라 의미가 다르다.
개가 사람을 물었다.
사람이 개를 물었다.
위 문장에서 토큰의 순서를 알려주지 않으면 Attention 만으로 두 문장을 제대로 구분하기 어렵다.
그래서 각 토큰 임베딩에 '몇 번째 위치에 있는 토큰인지 나타내는 위치 정보'를 더해준다.
이를 수식으로 나타내면 아래와 같다.
이렇게 하면 같은 단어라도 문장 안에서 위치가 다르면 서로 다른 입력 벡터가 된다.
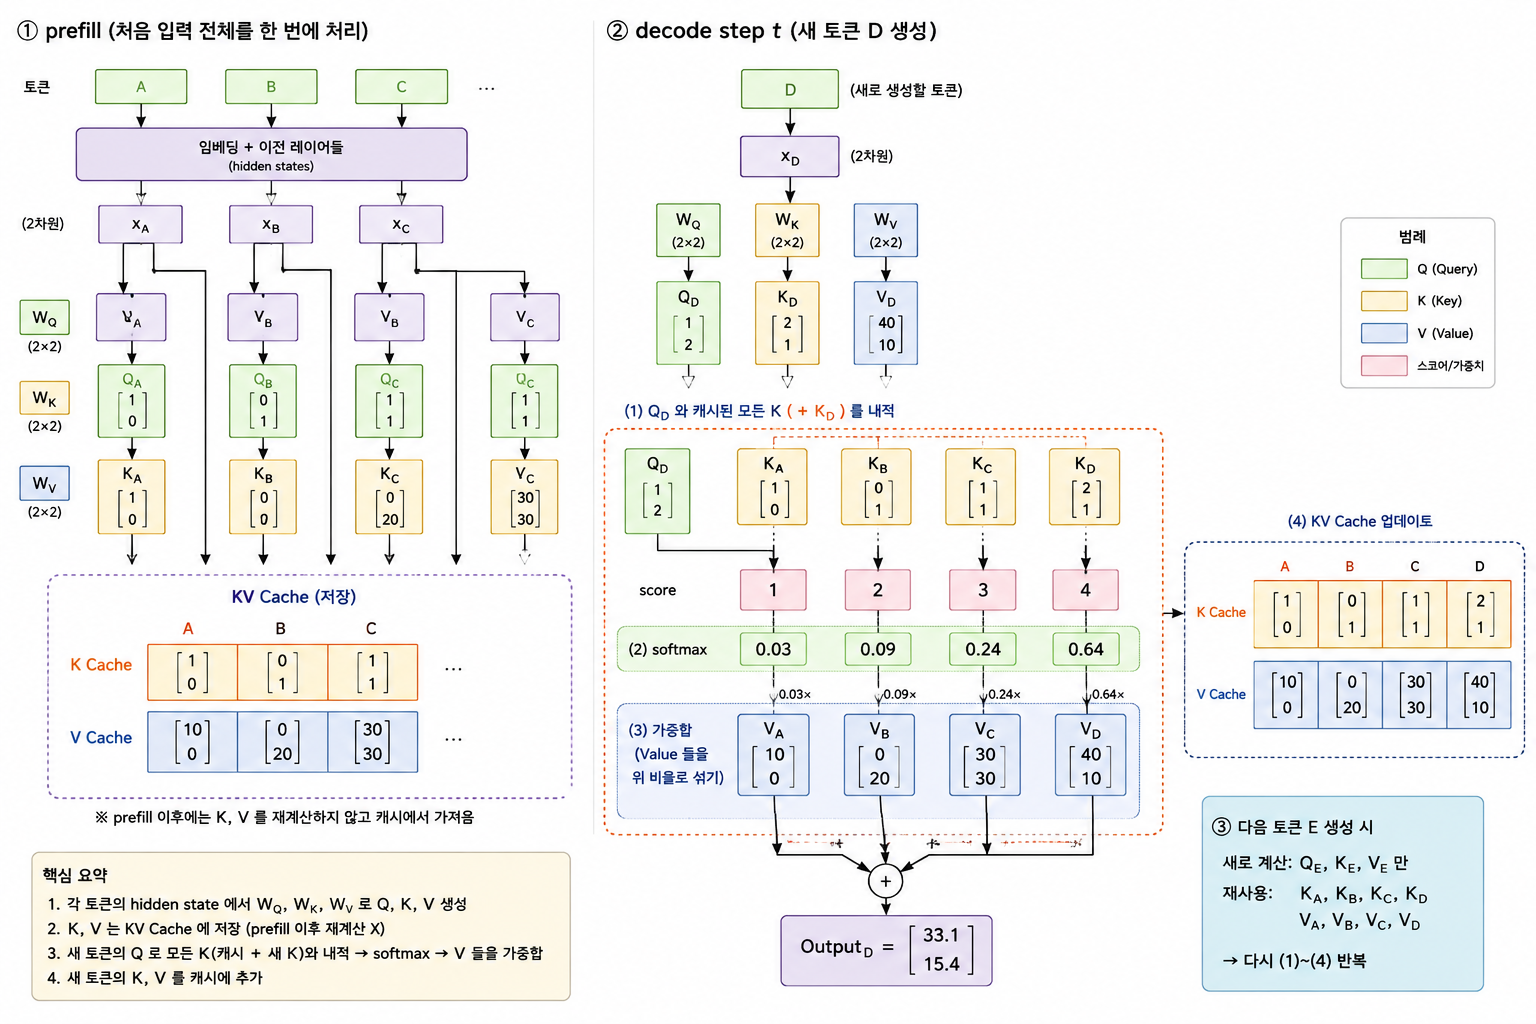
참고) KV Cache 시각화